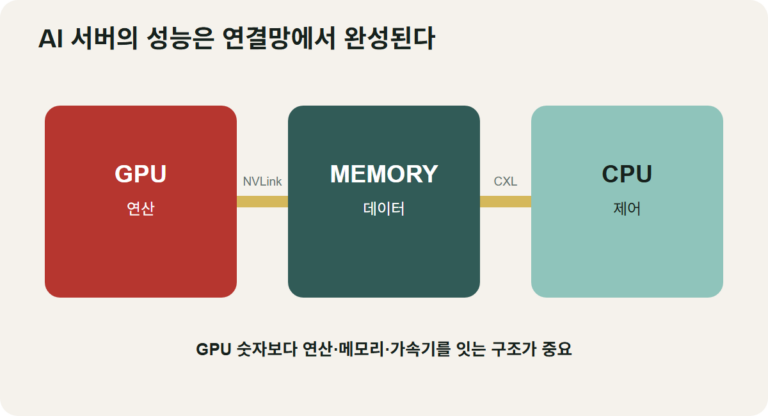
AI 반도체 기술⑥ CXL·NVLink — 칩을 넘어 서버 전체가 하나처럼 움직이는 이유
여러 GPU를 설치하는 것만으로 AI 서버가 빨라지는 것은 아닙니다. NVIDIA NVLink와 CXL의 차이, 메모리 풀링과 AI 데이터센터의 연결 구조를 쉽게 설명합니다.
본문 읽기 →불마켓 Bull Market News
미국 증시·AI·반도체·산업기술을 쉽게 읽는 뉴스
EDITORIAL HUB
여러 GPU를 설치하는 것만으로 AI 서버가 빨라지는 것은 아닙니다. NVIDIA NVLink와 CXL의 차이, 메모리 풀링과 AI 데이터센터의 연결 구조를 쉽게 설명합니다.
본문 읽기 →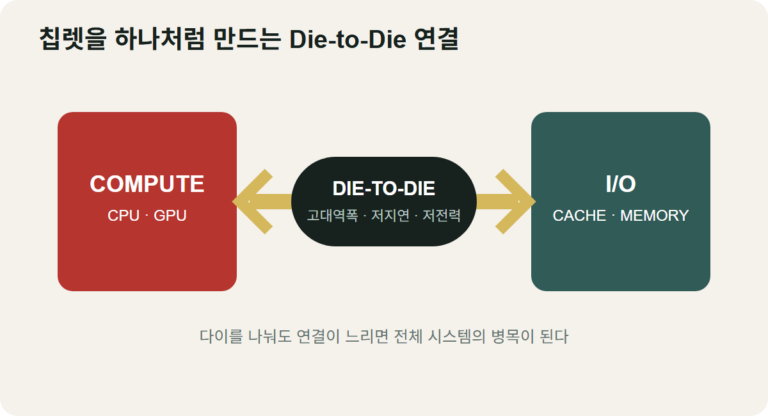
칩렛을 하나의 반도체처럼 동작시키는 다이투다이 인터커넥트의 원리와 UCIe 표준, AMD MI300 사례를 초보자도 이해하기 쉽게 설명합니다.
본문 읽기 →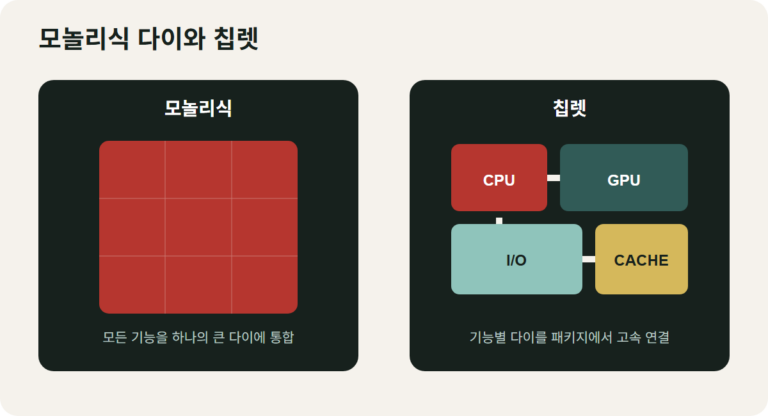
하나의 거대한 반도체 대신 여러 작은 다이를 연결하는 칩렛 구조를 쉽게 설명합니다. 모놀리식 한계, 수율과 비용, AMD·NVIDIA·Intel 사례와 UCIe를 살펴봅니다.
본문 읽기 →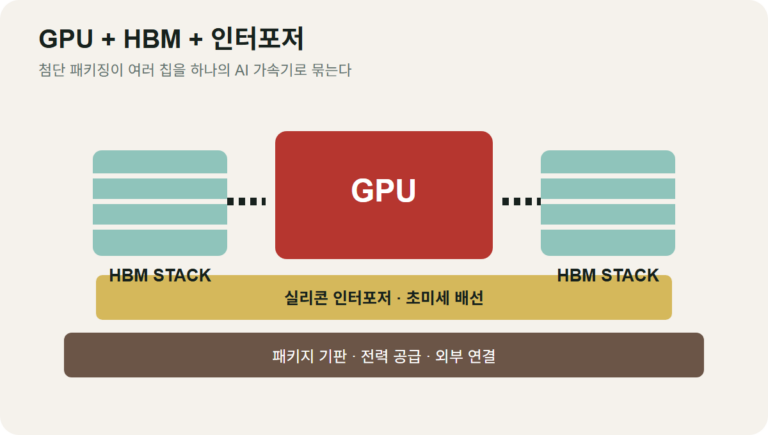
GPU와 HBM을 하나의 AI 가속기로 연결하는 첨단 패키징을 쉽게 설명합니다. 2.5D 패키징, 인터포저, TSMC CoWoS, 칩렛과 패키징 병목을 살펴봅니다.
본문 읽기 →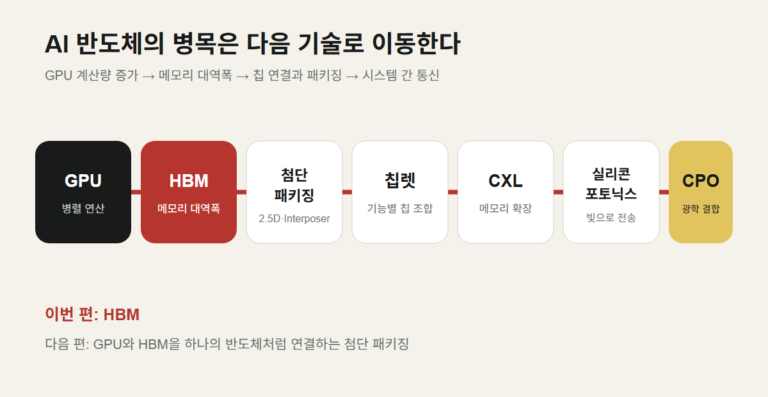
GPU가 아무리 빨라도 데이터를 제때 공급받지 못하면 기다릴 수밖에 없습니다. HBM의 대역폭, TSV 적층 구조와 첨단 패키징으로 이어지는 AI 메모리 산업을 초보자 눈높이에서 설명합니다.
본문 읽기 →